率先支持端侧具身世界模型:迈特芯亮相2026全球AI芯片峰会
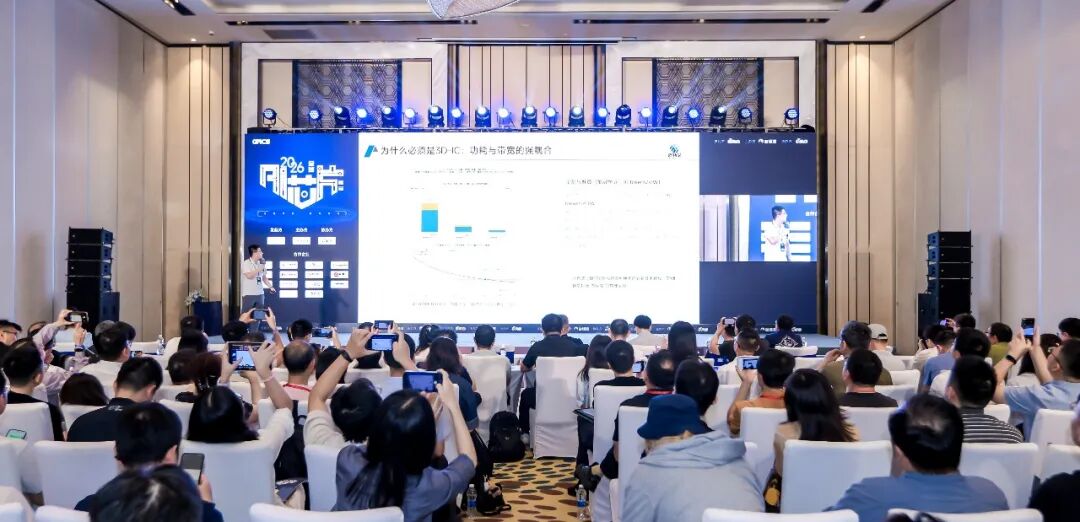
2026年9月21日,2026全球AI芯片峰会在上海落幕。这场由智东西发起、智猩猩主办、芯东西协办的行业盛会,以“芯路求索 聚力致远”为主题,两天内聚集超60位嘉宾、超百家AI算力生态企业。而在所有议题中,最受关注的,是一类刚刚被行业看清楚的方向:具身端侧算力。
端侧AI算力新锐迈特芯(Metachip)在这场峰会上两度登台,直接亮出了自己在具身智能领域的核心卖点——一款能跑VLA与WAM的3D AI芯片。VLA与WAM是具身智能当前的主流模型框架。过去,这两个任务通常要分给两套系统:云端GPU跑得动,但功耗几百瓦、进不了机器人本体;专用端侧处理器够省电,却因带宽不足与灵活性不高只能一条路线。而迈特芯用一套张量脉动架构与3D封装,把两条路线收进同一颗处理器:具身智能产品经理谢齐家在具身智能芯片高峰论坛分享了具身模型部署进展,芯片产品经理李凯博士在大模型AI芯片高峰论坛讲透了支撑它的底座。唯一能同时跑VLA与WAM,这就是迈特芯给出的答案。
01
为什么“同时跑VLA与WAM”这么难
VLA(视觉-语言-动作模型)让机器人理解指令、看懂场景;WAM(世界动作模型)让机器人预测物理世界、生成动作。一个负责“想明白”,一个负责“动起来”。
难点在于,这是两套截然不同的工作负载:
VLA主干是自回归/流匹配Transformer(如π0、WALL-OSS),偏理解与决策;
WAM主干是预测式世界模型(如Jepa-VLA、Meta-WAM),偏推演与动作生成;
两种负载云端GPU或专用单路线处理器都能应付;但在端侧同时支持却很难:算力、带宽、功耗、成本四个变量同时卡住。现实是,市面上要么只能在端侧跑VLA,要么只能用GPU跑WAM,能“双跑合一”的端侧方案,几乎没有。这正是迈特芯3D-TPU被行业高看一眼的原因。
02
一个底座,跑通两条路线
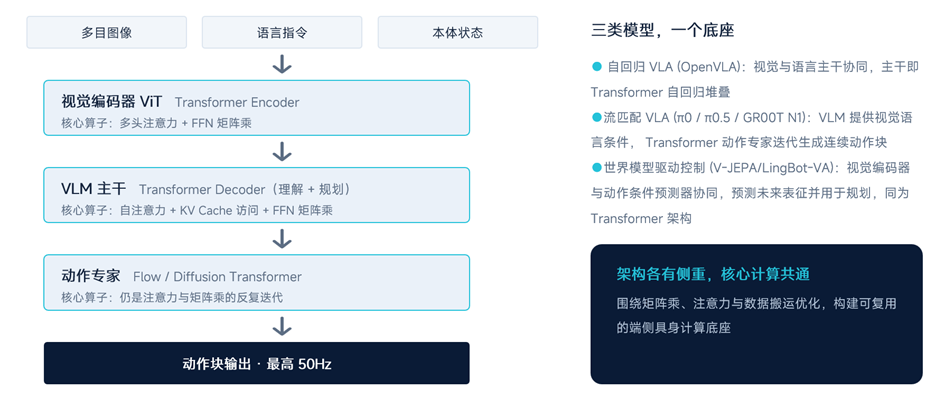
迈特芯的解法是“统一底座”:以自研张量脉动TPU为唯一硬件底座,一套数据流同时支撑LLM、MoE、VLM、VLA、WAM五类模型。关键洞察在于:无论VLA还是WAM,主干都是Transformer——同一个公分母,一套微架构就能覆盖。
三类模型,一个底座:自回归VLA(OpenVLA)、流匹配VLA(π0/π0.5/GR00T N1)、WAM(V-JEPA/LingBot-VA/自研Meta-WAM);
3D分布式直连架构让带宽利用率稳定在80%以上,消除算子间的数据重排开销;
端侧全链路闭环:视觉→语言→动作全程在端侧完成,不依赖任何云端回传。
这也是“唯一能同时跑VLA与WAM”的技术底气:不是把两套硬件拼在一起,而是让同一颗处理器把两条路线都跑通。
03
3D破局:把600GB/s带宽,塞进7W功耗
同时跑通两条路线,靠的是把带宽这个最大瓶颈先拆掉。迈特芯的思路很直接:把存储“搬”到计算头顶,用3D DRAM垂直封装让数据不再绕远路:
3D DRAM垂直叠加(Hybrid Bonding/TSV),提供约600GB/s带宽,功耗从2D方案的40W级压到7W级以内;
3D IO垂直直通每个处理单元,配合“立方脉动计算”,带宽利用率稳定在80%以上;
软硬件协同优化针对Transformer的算术特性做优化,消除算子间的数据重排开销。
两组硬核对比,能直观说明为什么“3D”是具身端侧算力的必答题:
表1 2D方案与迈特芯3D-PIM关键指标对比
评估维度 | 2D方案(LPDDR5X-9600基准) | 迈特芯3D-PIM(Hybrid Bonding) |
实现方式 | 32通道 LPDDR5X(16-bit/片) | 4个堆栈(16×1024-bit通道) |
能耗比 | 7.0~9.5 pJ/bit | 0.8~1.5 pJ/bit |
600GB/s下总功耗 | 33.6~45.6 W | 3.8~7.2 W |
互连延迟 | 约20-40 ns(含PHY延迟) | <5 ns(直接垂直互连) |
带宽利用率 | 传统2D NoC仅10%-50% | 3D分布式直连架构持续80%以上 |
同样的600GB/s带宽,功耗从40W级压到7W级以内;同样的数据搬运,带宽利用率从10%-50%跃升到80%以上——这正是机器人“装得上端侧算力、跑得起双路线”的分水岭。
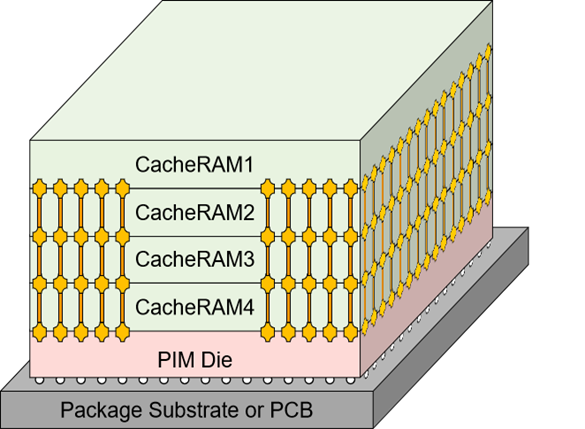
图3:迈特芯3D-DRAM TPU示意图
04
“大小脑”异构:让机器人边用边学
能“动起来”只是第一步,真正让具身智能走出实验室的,是“越用越聪明”。迈特芯提出了“大脑+小脑+脑干”三级异构方案:
大脑(3D-IC大脑处理器):约10Hz慢系统,部署多模态大语言模型,负责任务理解与语义规划;
小脑(3D-IC小脑处理器):约100Hz快系统,部署VLA动作生成层与残差强化学习,负责实时动作策略;
脑干(底层运控单元):约1KHz反射层,负责伺服运控。
这套架构带来的直接效果,是“边用边学、持续进化”:在真机交互中,机器人就能把OOD(分布外)任务成功率自主学习提升,不依赖云端回传与离线重训练。同时,端侧Few-Shot微调正在成为端侧算力的必答题——数据不出门、隐私不上云,迈特芯的端侧4B SFT能力已经在路上。
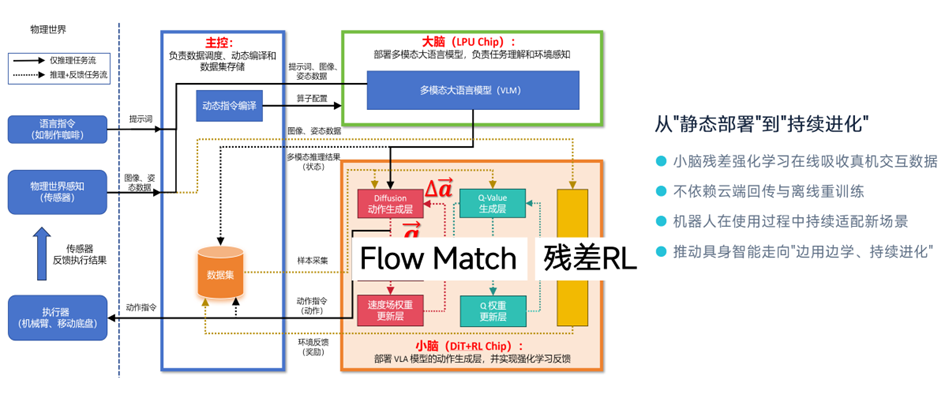
图4:迈特芯“大脑+小脑+脑干”三级异构架构
05
应用落地:两种模型,一个底座
技术讲得再漂亮,跑不上真机都是纸上谈兵。围绕客户的真实需求,迈特芯用VLA与WAM各跑通了一个真机Demo:
VLA一路,部署的是自变量机器人的开源模型WALL-OSS:机械臂听懂指令、识别目标方块,自主规划轨迹并完成夹取;
WAM一路,部署的是迈特芯基于JEPA自研的Meta-WAM:机械臂先"预想"按下按钮之后会发生什么,再生成动作、伸手按下电梯。
两个Demo,两条截然不同的模型路线,跑的是同一套硬件平台。这既是迈特芯的一次实战练兵,也让"具身智能通用算力底座"从方案变成了真机上看得见的动作——客户带着自己的模型来,就能在这颗芯片上跑起来。
视频备注:迈特芯VLA端侧部署(机械臂夹取方块)
视频备注:迈特芯WAM端侧部署(机械臂摁电梯)
06
唯一能“双跑合一”的具身AI芯片即将量产
技术路线之外,李凯博士在现场给出了更硬核的进展:
统一底座,解决“算什么”:一套数据流同时支撑LLM、MoE、VLM、VLA、WAM五类模型,从端侧语言一路跑到具身动作;
量产时间表:2D-TPU(088处理器)已于2026年2月成功点亮并跑通语音模型;3D-TPU(188)逻辑部分本月制造完毕,预计11月初回片点亮,首批适配2B-9B模型,平均功耗约6W、推理速度预计80 tokens/s;
产品矩阵:Mega188(高性能3D近存TPU,单颗19×19mm承载机器人算力核心)、Mega088(22nm ULP语音处理器)、MetaClaw(智能体软件平台,覆盖九大落地场景)。
“点亮不是简单封在一起,而是模型真正跑起来,有数据、有性能。”围绕“端侧AI算力+智能体软件平台”,迈特芯已在具身智能(机械臂、机器狗、送餐机器人)、智慧教育(AI-Pad)、政务信创(AI-PC)、家庭终端(AI-NAS)、智能座舱(AI-语音)等场景完成软硬一体布局,步步高、美的、德赛西威等头部厂商已进入验证与定制合作。按照规划,MEGA一代(188)之后,MEGA二代将走向AI手机、AI笔记本,MEGA三代将覆盖AI汽车、机器人与云推理服务器——带宽每一代翻倍,为更大模型与端侧微调预留空间。
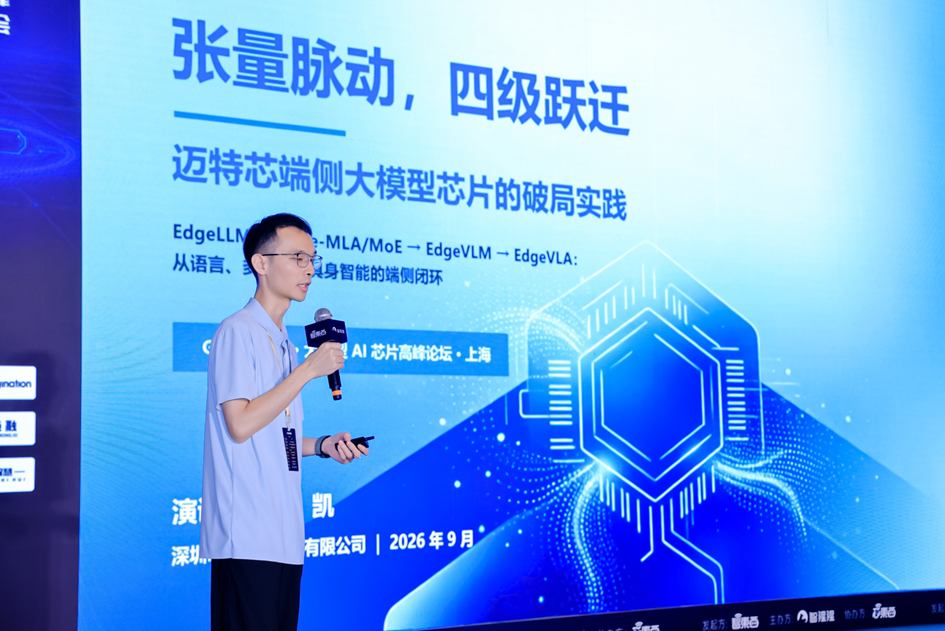
图7:迈特芯李凯博士现场演讲照片
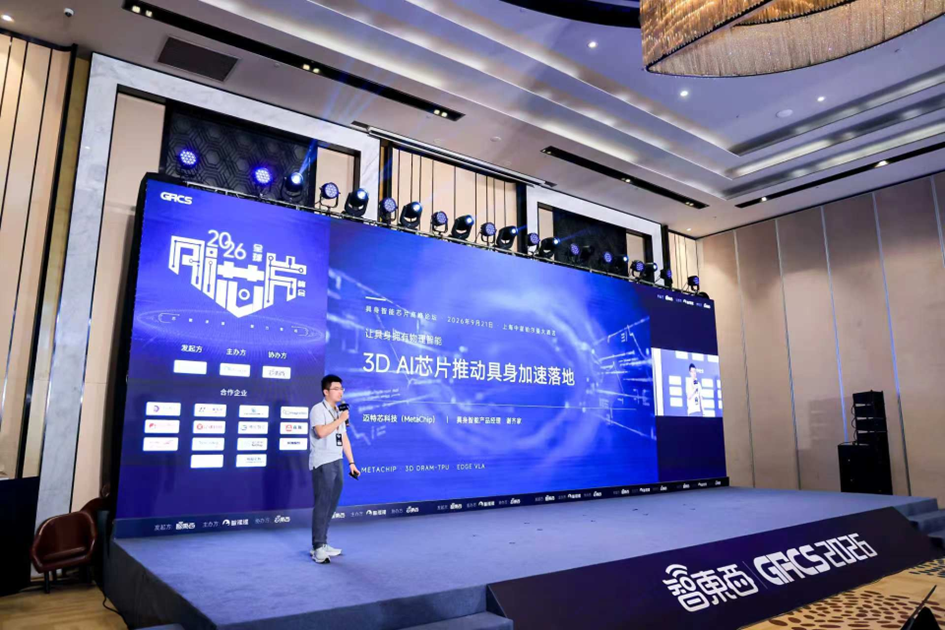
图8:迈特芯具身智能产品经理谢齐家现场演讲照片
写在最后
VLA让机器人看懂世界,WAM让机器人预判世界——而迈特芯把两者收进了同一颗处理器。从2D点亮到3D量产,从语言推理到机器人在真实世界里夹起方块、按下电梯按钮,迈特芯用三年时间,把“唯一能同时跑VLA与WAM”从一句口号,变成了300毫秒内完成的动作闭环。
“赋能人人文明级AI,实现数字服务平权。”当3D-TPU在下个月回片点亮,机器人将第一次真正“装上大脑、跑进生活”——而这,只是具身智能大规模落地的开始。
扫一扫,分享到微信
