不止于TOPS:端侧大模型芯片的效率之争|《WAIC UP!》辑趣

发布日期:2026-10-14 09:00:00  来源 : 世界人工智能大会    作者 :迈特芯    浏览量 :0
迈特芯 世界人工智能大会 发布日期:2026-10-14 09:00:00  
0

作者:余浩教授


余浩,南方科技大学深港微电子学院长聘教授、迈特芯科技创始人。


1999年获复旦大学学士学位,2007年获美国加州大学洛杉矶分校电子工程博士学位。曾任新加坡南洋理工大学助理教授、集成电路研究中心主任,2017年加入南方科技大学。长期从事高性能集成电路设计研究,包括人工智能芯片。


入选国家科技创新领军人才、英国工程协会会士等。其带领的团队曾获国际ACM期刊3DIC最佳论文奖、世界机器人大会最佳论文奖、中国吴文俊人工智能技术发明奖、及人工智能芯片专项奖。目前通过深圳迈特芯科技,推动低功耗端侧大模型芯片的产业化落地。


全文共4671字,预计阅读时间19分钟


2026年被行业公认为“端侧AI元年”。AI手机、AI PC、具身智能机器人不再只是展会上的概念样机,而是开始批量进入千家万户。大模型不再只是云端机房里的“私有财产”,它必须走出恒温恒湿的数据中心,进入我们的口袋、桌面、工厂车间乃至野外作业现场。然而,在这一片繁荣的产业图景背后,横亘着一道冷酷的物理铁律:云端看算力,端侧看功耗;云端拼峰值,端侧拼效率。

过去两年,行业已经在制程工艺上从7nm卷到3nm,但一个被普遍忽视的现实是:端侧的“功耗墙”并不会随着制程升级自动消失。大量行业测试数据显示,当前市面上超过60%的端侧AI芯片,在被动散热5W的功耗红线内,无法稳定跑通7B以上的稠密大模型——要么因带宽不足导致推理速度跌至可用阈值以下,要么为堆算力牺牲能效比,最终发热严重、续航崩塌。所以,我们急需建立一套新的终端推理标准,即:端侧大模型芯片的评估体系必须从单纯的峰值算力(TOPS)竞赛,转向以有效内存带宽(GB/s)、能效比(TOPS/W)和实际模型吞吐量(tokens/s)为核心的综合指标体系。


一、从技术垄断到“人人文明级AI、数字服务平权”的底层诉求


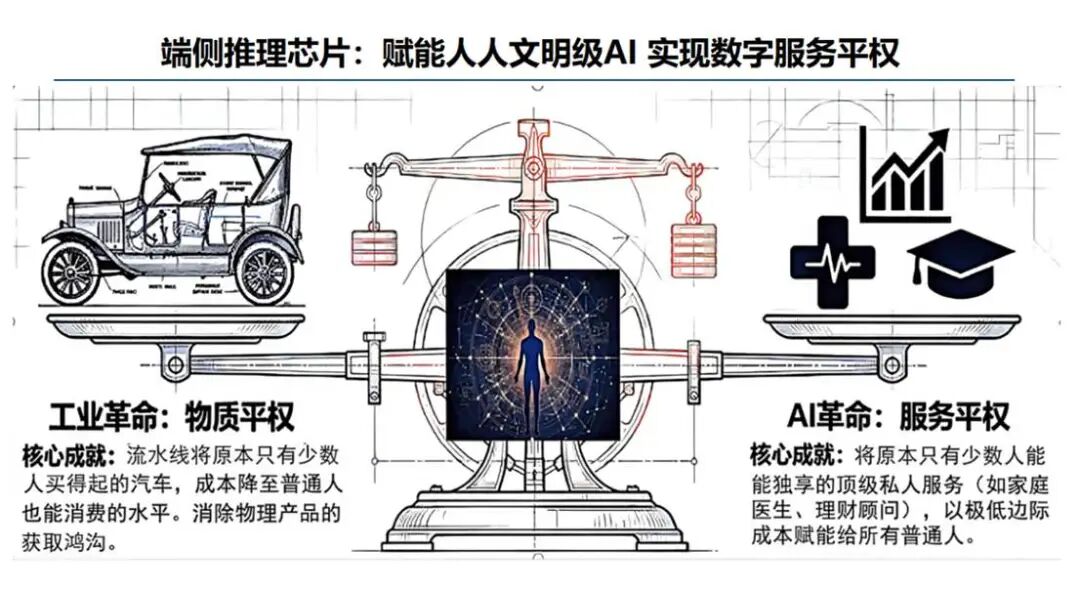
要理解端侧芯片变革的必要性,首先需要跳出单一技术视角,重新审视AI发展的终极社会形态。工业革命通过流水线将汽车从奢侈品变成大众消费品,完成了“物质平权”;而当下AI时代的变革,本质是要把原本只有科技巨头、顶尖实验室通过昂贵API和强算力集群才能调用的“顶级智能”,变成普通人触手可及的公共基础设施。我们可以将其概括为“人人文明级AI”(Civilized AI for Everyone)。

这里的“文明级”,核心不是大模型的参数规模必须达到千亿万亿,而是指无需依赖云端、无惧隐私泄露、不受网络波动影响的人工智能服务才是真正的“文明级”。比如:偏远地区的孩子用千元平板,在无网环境下通过本地运行的9B/27B模型获得一对一辅导;独居老人佩戴轻便智能眼镜,在信号微弱的家中获得全天候健康陪护。

但当前行业存在一个普遍误区:不少厂商将端侧AI简化为“云端模型的裁剪版”,试图用小参数、低精度的模型强行适配终端,结果导致智能体验大打折扣。如果智能服务始终只有能承担高昂算力成本和数据流量的少数人能用,技术不仅不会消除鸿沟,反而会制造新的“智能代差”——城乡、区域间的知识获取能力差距将进一步拉大。正如电力、自来水最终成为公共事业,人工智能也必须成为像水、电一样的基础设施,无门槛、无差别供给,这才是数字服务平权的核心内涵。


二、词元循环经济:重构云边端协同的行业新范式


要实现数字平权,整个行业必须跳出“集中式云推理”的路径依赖。过去十年,移动互联网的典型模式是:终端采集数据上传,云端计算生成Token(词元),再回传终端展示。这种模式在大模型时代已经暴露出三个难以调和的结构性矛盾,至今尚未得到系统性解决:

一是隐私合规风险。随着《中华人民共和国数据安全法》《中华人民共和国个人信息保护法》落地,医疗诊断、金融交易、生物特征等敏感数据的云端传输面临越来越高的合规压力,用户对隐私泄露的担忧也在持续上升,数据“不出域”已经成为大量B端场景的刚性要求。

二是延迟天花板。工业机械臂实时控制、自动驾驶毫秒级避障等场景,对响应延迟的要求往往在10ms以内,而云端往返仅物理距离带来的光速延迟就超过20ms,即使网络条件极佳也无法突破。目前行业内不少宣称“端云协同”的方案,实际落地时仍频繁出现卡顿、断连问题,核心原因就在于此。

三是成本不可持续。随着大模型调用量激增,长期租赁云端算力的成本会呈指数级上升,最终要么推高终端售价,要么倒逼厂商限制功能,阻碍AI技术普惠。

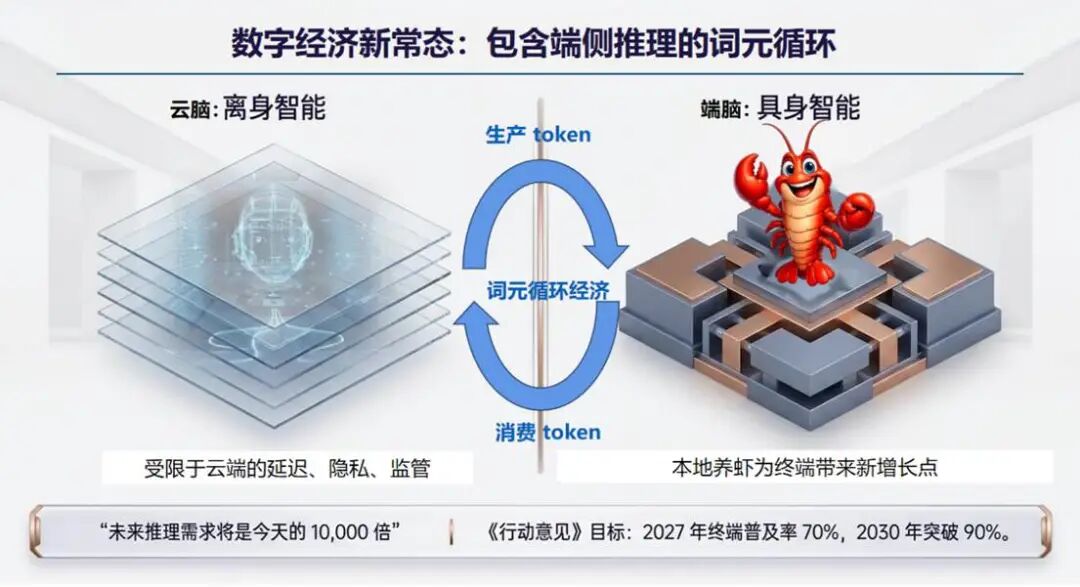
正是在这样的背景下,我们团队提出的“词元循环经济”(Token Circular Economy)正在成为新的行业共识。其核心逻辑是将Token从单向流动变为双向闭环:云端生产通用基础Token,终端消费Token后,结合本地私有数据和实时环境再生成个性化Token,脱敏后再回流云端优化全局模型。这类似于从“集中发电”向“分布式能源互联网”转型,每个节点既是消费者又是生产者。

但在这个闭环中,端侧推理的“最后一公里”问题始终突出:现有端侧芯片大多无法在弱网、断网场景下提供足够的推理能力,导致词元循环在物理层断裂。行业调研显示,当前约70%的端侧AI方案,在地下车库、矿井、野外等弱网环境下的可用性低于30%。低延迟、高词元效率的端侧AI芯片,已经成为打通词元循环的核心短板,也是下一代AI生态竞争的战略制高点。


三、端侧推理3D-TPU路径:带宽与利用率重写规则


当我们明确了端侧AI的诉求,再回头审视当前主流芯片架构,会发现一个普遍错位:现有端侧芯片大多是基于云端训练或传统CV(计算机视觉)任务架构改良而来,并不适配大模型推理的核心需求。过去行业惯用的TOPS(每秒万亿次运算)、制程节点、理论带宽这“老三样”评价指标,在大模型场景下参考价值已经大幅下降。

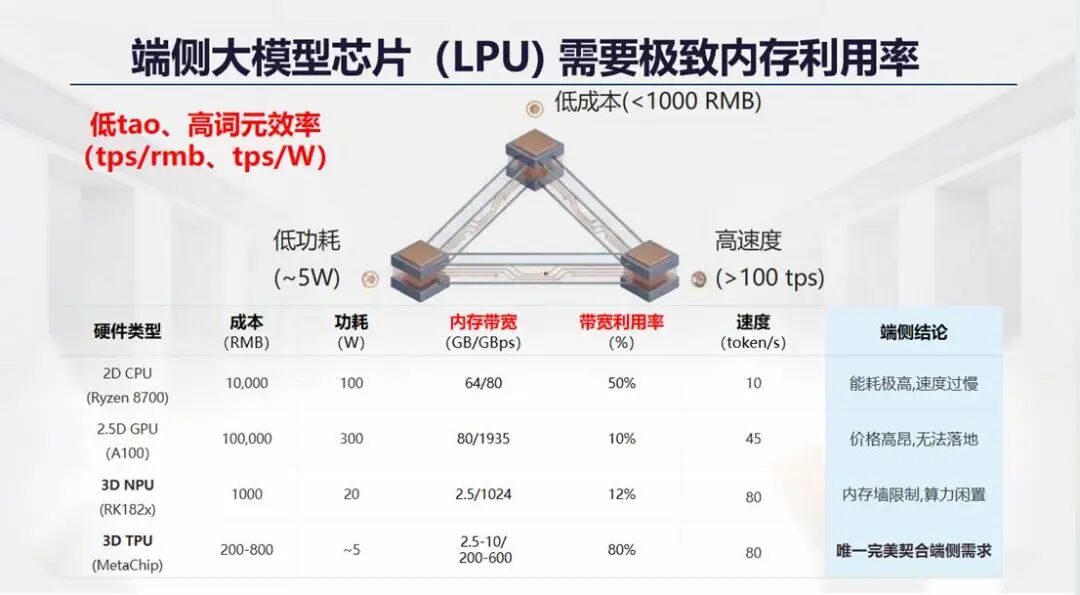
根本原因在于:大模型推理(尤其是Decode解码阶段)是典型的“内存密集型”负载,而非“计算密集型”负载。这就好比一个消化能力极强的胃,却因为食道狭窄而“吃不饱”。不少芯片理论算力动辄上百TOPS,本质上这是一个假设所有算术单元被完美喂饱、利用率为100%的“虚荣指标”,在实际运行时,计算单元80%以上的时间在等待数据从内存搬运,而带宽利用率才是打破“内存墙”瓶颈触摸算力上限的关键因素。

从技术演进方向来看,3D-DRAM近存计算+立方脉动TPU架构已成为打破端侧大模型芯片“不可能三角”(低功耗、高性能、低成本)的最优选择。其优势体现在三个物理层面:

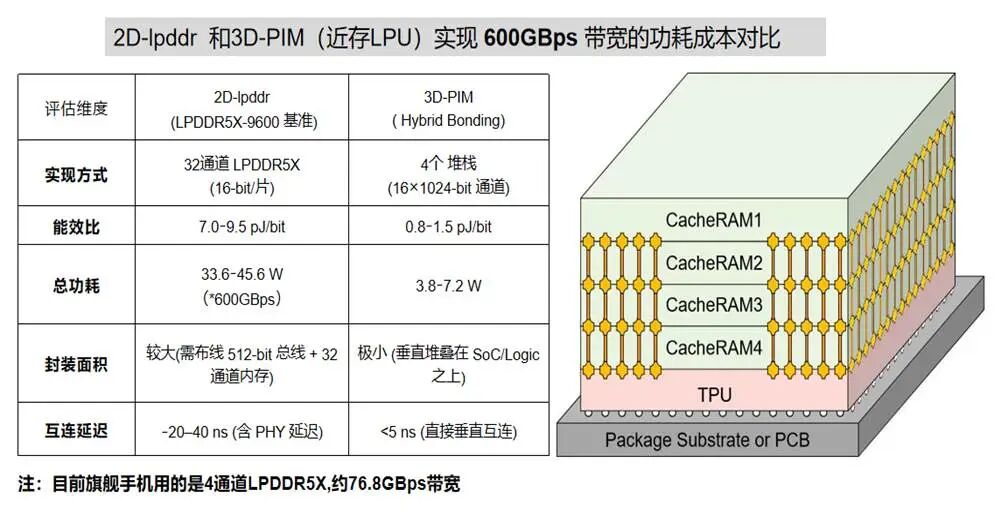
第一,3D内存带宽对2D总线的降维突破。为了支持GigaByte级别的大模型,传统2D方案需要实现每秒600 GB 的数据传输能力才能保持通畅交互。这需要用32通道的LPDDR5X,在电路板上要拉32条厘米级别的粗电线,总功耗高达33.6到45.6W。现在,3D方案用混合键合技术,把存储芯片直接叠在处理器芯片上面,通过1024根微米级别电线就能实现每秒600 GB的数据传输能力,平均功耗可以降到5W的极低水平。所以,3D-DRAM能在5W功耗低功耗的水平下实现每秒钟处理(生成或输入)80个token的速度(1个token近2GB数据吞吐)。因此端侧大模型计算瓶颈,本质上不是需要算力堆得高,而是需要突破2D数据传输的物理带宽,以及相关的带宽利用率。


第二,立方脉动架构大幅提升带宽利用率。在3D堆叠基础上,立方脉动数据流让计算单元与内存垂直直通,模型权重可以常驻3D堆叠内存,数据在计算阵列中沿立方网格流动,无需频繁访问外部存储,带宽利用率可提升至80%左右。这种架构的本质是“算法即架构”——将矩阵运算的输入数据存取从开销巨大的L2缓存甚至内存访问,变成相邻处理单元(PE)之间在全局时钟驱动下的直接传递,用确定性数据流动规避了传统架构中不可控的访存延迟。在权重驻留(Weight Stationary)模式下,权重在推理开始前即预载入每个PE的寄存器中,输入数据沿阵列水平流动、部分和沿垂直方向累加传递,权重仅需一次加载即可供所有输入重复使用,这正是立方脉动架构能在平均5W功耗下实现约80tokens/s的根本原因。

第三,成熟制程的架构红利释放。过去行业陷入“唯先进制程论”的误区,但3D堆叠架构证明,通过架构创新可以充分挖掘成熟工艺的潜力。实测数据显示,采用该架构的芯片在3B模型INT4量化、Decode阶段,平均5W功耗下可实现约80tokens/s的推理速度,词元能效比达到15token/W,较同场景竞品高出近一个数量级。


从Roofline模型视角来看,芯片实际能发挥的等效算力取决于“脊点”——即峰值算力与内存带宽的比值:当模型算力强度高于脊点时受算力限制,低于脊点时则完全受带宽制约。

基于这些实践,行业亟须建立新的评估标准,从关注“多少TOPS”转向三个核心指标:5W功耗内能跑多大的模型(≥7B为优秀)、带宽实际利用率(≥75%为优秀)、单位成本模型承载力(B/$)。只有这三个指标达标,端侧AI才能真正走出实验室,走向规模化落地。


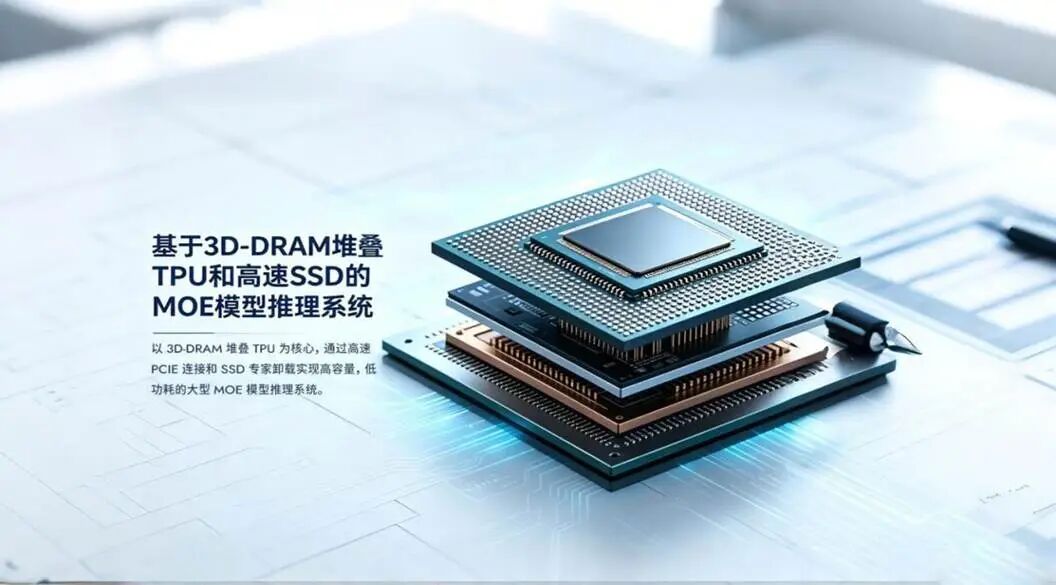
四、存算协同新范式:基于3D DRAM-TPU与SSD的专家卸载架构


当前GPU/CPU方案通过超大内存、显存和多卡并行,已实现大模型的高效本地部署。但面对内存、显存价格不断上涨的现状,该方案成本居高不下,难以进入消费级市场及边缘场景。且在面对Qwen3.6-35B-A3B 这类“总参35B、激活仅3B”的MoE(混合专家)模型时,常规部署方式通常仍将全部权重常驻内存,无法利用MoE“大总参、小激活”的优势,结果出现“需预留40GB内存、实际仅用到约2GB”的尴尬局面(按激活3B参数、INT8精度估算)。

面向追求极致性价比的端侧场景,3D DRAM-TPU方案(国内以迈特芯等为代表)首先提供600GBps带宽及高达80%带宽利用率,来流畅支持2-9B、27B的稠密端侧大模型;其次通过“片上常驻+SSD冷存”分级卸载架构,来支持35B、70B等稀疏MoE端侧大模型。不同于传统GPU/CPU完整参数全部载入的思路,依托3D堆叠DRAM 的带宽优势,仅将KV Cache 与共享专家划入“常驻分区”,一次性写入 TPU 片上的3D DRAM,确保每轮推理零等待访问。

在调度层面,该架构引入专家预测调度系统:基于历史路由信息与当前状态提前生成候选专家集合预取队列,极大地压缩token间专家读取等待时间;即使预测未命中,也可按实时命中的专家编号从SSD调取对应路由专家,兼顾计算正确性与吞吐效率。为家庭AI PC、具身智能主机等场景提供“无需依赖云端”的实时AI体验,让隐私敏感的医疗诊断、本地知识库问答等应用真正落地边缘。

20260813215217_2bd2a6863234ec3dcfe1bd2cf0296eb4


五、端侧AI落地的行业路径:从微型终端到高性能场景


技术范式的创新最终要落地到产品上,当前行业端侧AI芯片的落地已经呈现出两条清晰的路径:

第一条是微型终端的轻量化路径。针对智能手表、AR眼镜等对功耗和体积极度敏感的场景,行业正在推进低功耗TPU方案落地:采用RISC-V精简指令集加张量脉动架构,支持Transformer全谱系模型,峰值能效比可达130TOPS/W以上,全电压段功耗低于1W,成本控制在1美元以内,能够适配0.6B级别的小模型,解决“小终端有没有AI”的入门问题。目前这类方案已经在部分可穿戴设备中试商用,初步验证了可行性。

第二条是高性能端侧的主流落地路径。面向AI手机、AI PC、具身智能等核心场景,3D-TPU架构正在从实验室走向样片阶段,根据内存容量和带宽差异,细分出了不同的产品梯队:2GB级3D-DRAM、200GB/s带宽、最低2W功耗的方案,支持2B级模型,适配智能手机和轻量级可穿戴设备;5GB级3D-DRAM、400GB/s带宽、最低5W功耗的方案,支持4B级模型,瞄准AI平板、高阶NAS及轻型机械臂;10GB级3D-DRAM、600GB/s带宽、最低7W功耗的方案,配合KV压缩等技术可流畅运行9B、27B级稠密大模型,适配AI-PC、高端NAS、具身智能主机等场景。这一“按场景分级、按功耗定档”的产品思路,与谷歌TPU从训推一体走向训推彻底拆分(TPU v8将训练与推理拆分为独立ASIC)的行业大趋势一脉相承——专用程度越高,能效比越极致。

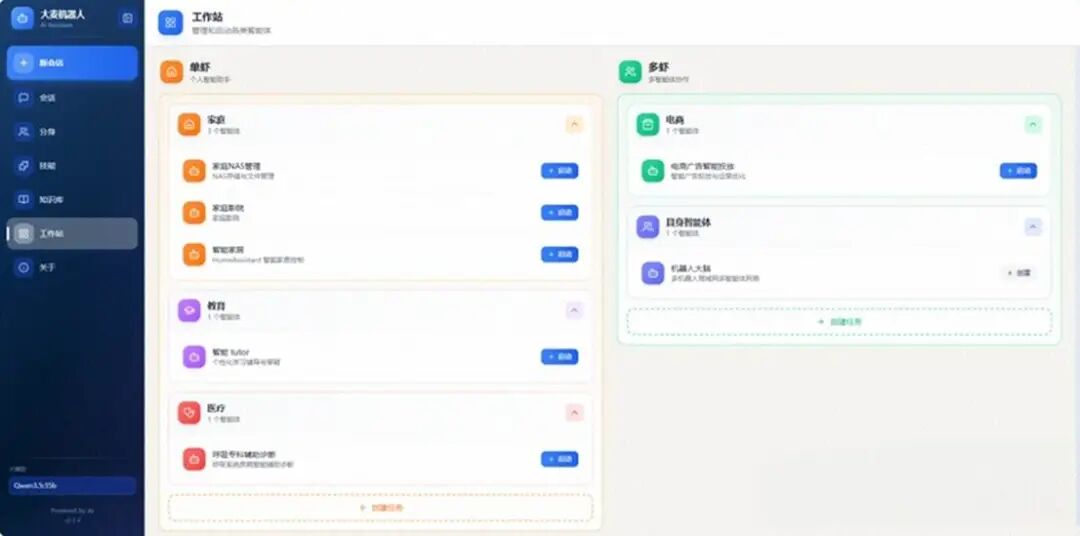
在软件生态构建层面,行业正加速推进端侧智能体框架的研发,旨在跨架构适配各类端侧芯片,在确保推理精度无损的前提下,实现低延迟、高隐私保护的本地化AI体验。多家端侧芯片企业已在这一方向上展开布局,例如迈特芯基于3D-TPU架构优化的AI智能体MetaClaw,已深度适配千问Qwen、面壁MiniCPM、谷歌Gemma等主流端侧大模型,展现出卓越的跨模型兼容能力,并且已在NAS私人助理、K12教育辅导、基层医疗辅助及具身智能控制等场景展开试点应用,成功验证了“端侧生成+消费Token”的完整技术闭环。MetaClaw表明,端侧AI Agent操作系统的未来演进,不在于盲目堆砌参数,而在于深度“沉降”——向硬件底层下沉、向具体业务逻辑渗透、向每一个本地化的家庭与办公节点落地。

a5af2917e806a61b1bdf1f78174ace02

2026—2027年,中国端侧AI芯片行业将迎来关键的洗牌期,市场会变得越来越残酷。仅靠PPT讲故事的“演示级芯片”会被淘汰,只有在超低功耗下能提供高带宽利用率、真正跑通全量模型的方案才能存活。

过去行业习惯了“追制程、堆TOPS、拼单点参数”,但现在大家逐渐意识到:端侧场景的核心矛盾从来不是“算不够”,而是“搬不动、耗不起”。当10GB内存、600GB/s带宽、5W功耗逐渐成为端侧芯片的标配,人人文明级AI才不会是口号,数字服务平权才有坚实的硬件基础。这不仅是技术路线的胜利,更是工程思维的回归——在物理约束中寻找最优解,在有限条件下创造普惠价值,这才是端侧AI的真正意义。

分享到:

长按或扫码识别 分享给好友

长按或扫码识别 分享给好友
公司地址:深圳国际创新谷1栋A座28层2801
Copyright©2025深圳市迈特芯科技有限公司版权有所
粤ICP备2026123998号-1
支持 反馈 订阅 数据